Fra ét billede i sekundet til målrettede gensyn
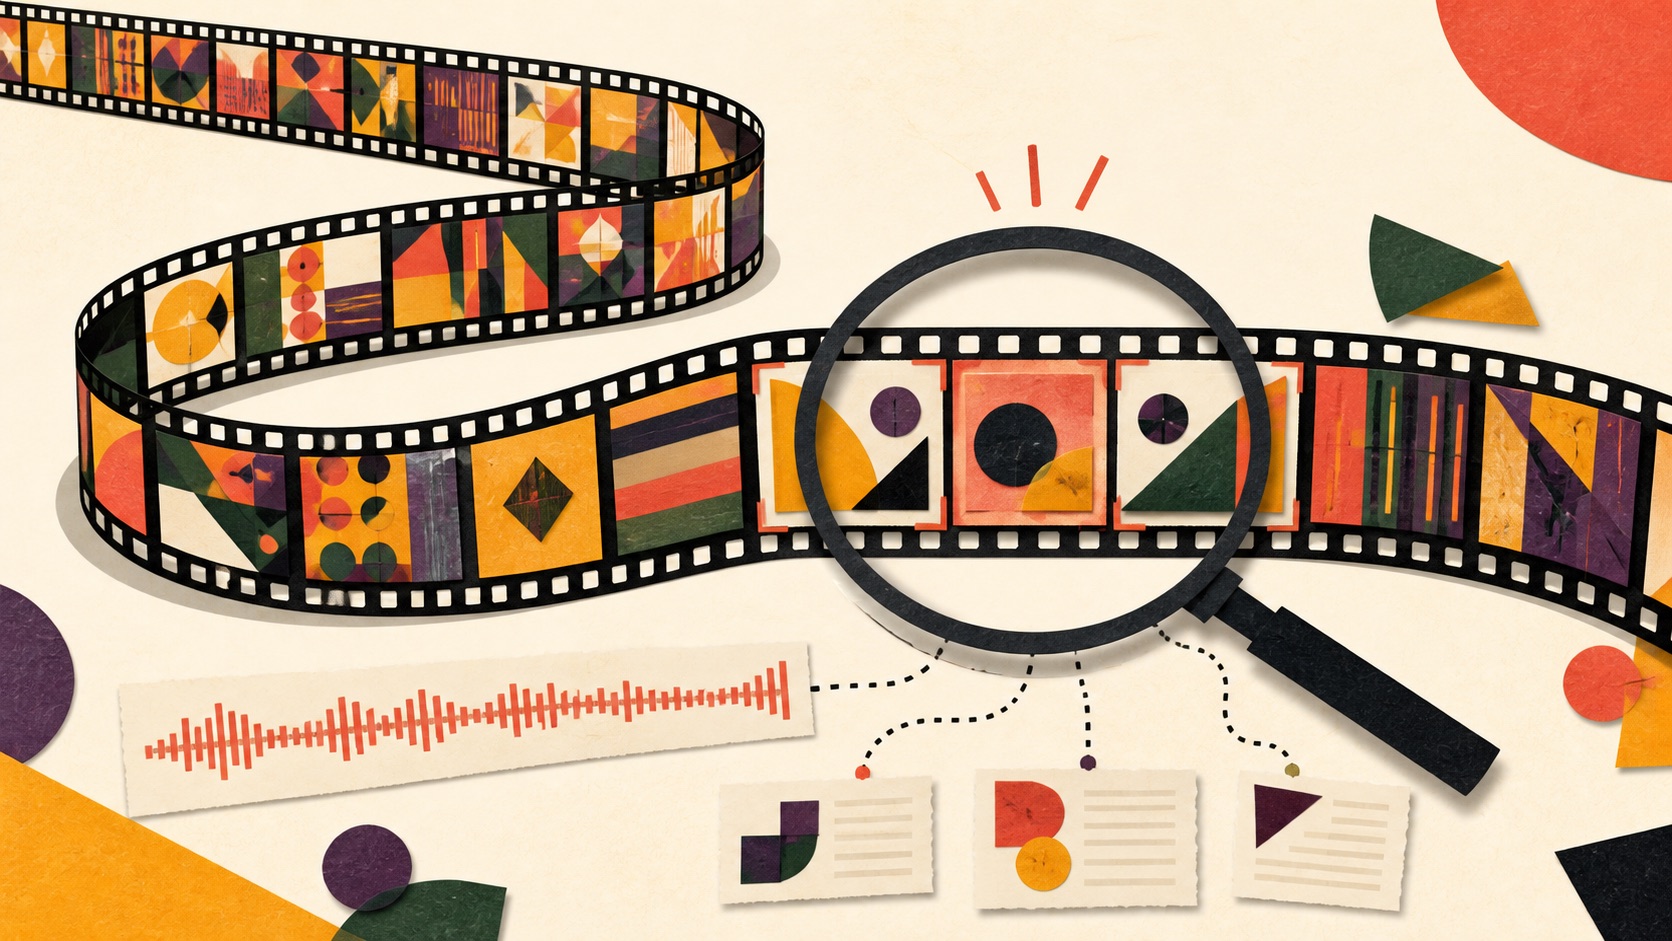
Geminis almindelige videotilstand udtrækker som standard ét billede i sekundet og lægger materialet ind i modellens kontekst på én gang. Det er enkelt, men et kort sceneskift eller en hurtig bevægelse kan falde mellem de valgte billeder. Omvendt bliver lange optagelser hurtigt tunge at behandle, hvis billedraten hæves over hele videoen. I den agentiske tilstand bliver spørgsmålet styrende. Leder brugeren efter et bestemt øjeblik, kan modellen først bruge lyd eller udskrift til at afgrænse området og derefter hente flere billeder fra netop den sekvens. I svaret kan udvikleren se særlige behandlingskald, som viser, at modellen faktisk har navigeret i videoen undervejs.Google måler lavere forbrug og lidt bedre svar
I Googles egne test bruger funktionen op til 88 procent færre tokens og kan reducere analyseprisen med op til 66 procent. Kvaliteten stiger samtidig med op til syv procent på de anvendte videoprøver. Gevinsten er størst på længere materiale, hvor en model ellers kan fylde sin arbejdshukommelse med mange sekvenser, som ikke er relevante for spørgsmålet. De højeste tal er ikke et løfte for enhver video. Resultatet afhænger blandt andet af længde, spørgsmål og hvor tydeligt de vigtige spor findes i billeder, lyd eller udskrift. Googles dokumentation anbefaler fortsat den almindelige statiske behandling til korte klip under fem minutter, når lav svartid eller ensartet billeddækning er vigtigere end selektiv søgning.Udviklere får funktionen før almindelige brugere
Agentisk videoforståelse kan nu vælges i Gemini API gennem Google AI Studio og Gemini Enterprise Agent Platform. Den understøttes af Gemini 3.7 Flash, 3.6 Flash og 3.5 Flash-Lite og kan bruges på både uploadede videoer og offentlige YouTube-videoer. Funktionen koster ikke et særskilt tillæg, men den almindelige tokenpris gælder stadig. For almindelige Gemini-brugere er lanceringen endnu ikke fuldt gennemført. Google siger, at teknikken snart skal rulles ud i Gemini-appen på Flash-modellerne. Den skal også forbedre funktionen Ask YouTube på selve videosiden i de kommende måneder. Selskabet angiver ikke en præcis dato for nogen af de to bredere udrulninger.Videosøgning kan blive mere præcis end et resumé
Den oplagte anvendelse er ikke kun at opsummere en forelæsning. En model kan lede efter et meget kort øjeblik, tælle gentagne handlinger eller undersøge en sekvens med højere billedrate, hvis noget ser usædvanligt ud. Det kan gøre videoarkiver mere søgbare og give redigeringsværktøjer et mere præcist udgangspunkt. Til gengæld lægger metoden mere ansvar over på modellens valg af, hvad der er værd at se. Hvis den afgrænser søgningen forkert, kan den i princippet spare ressourcer ved at springe over netop det afgørende signal. Den nye tilstand gør derfor ikke en lang video til sikker viden; den gør det billigere og mere fleksibelt for en AI at lede efter belæg i den.Der er benyttet AI til at skrive denne artikel.