En prøve, hvor begge sider afleverer i en lukket kasse
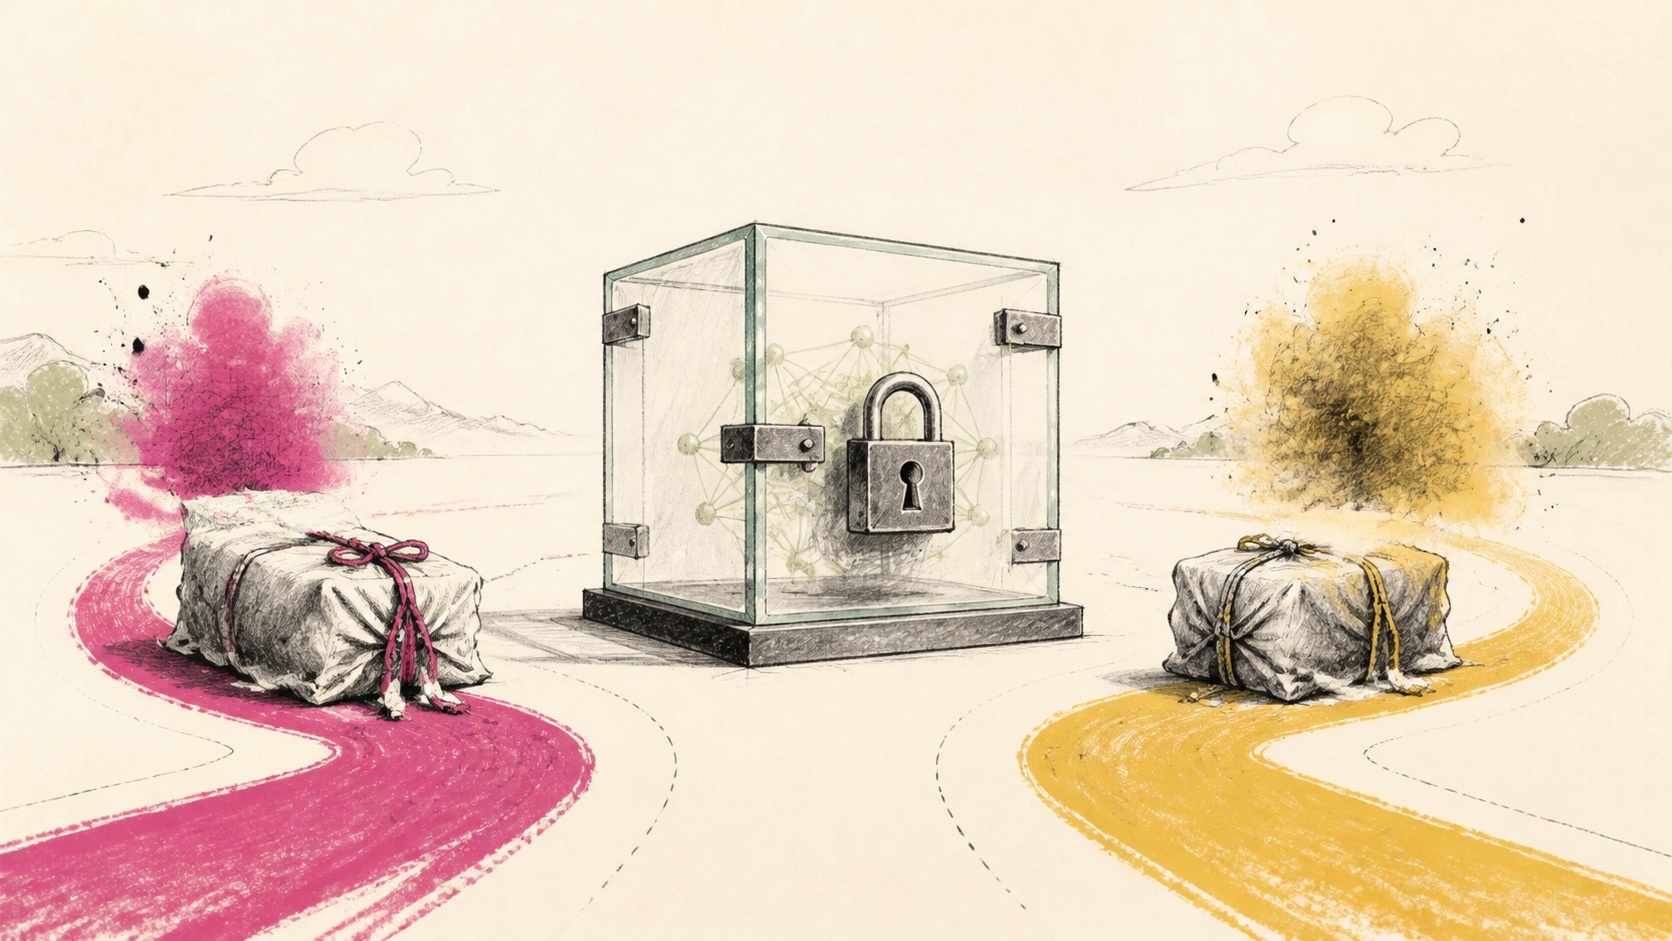
Normalt opstår der et dilemma, når en ekstern organisation vil undersøge en lukket AI-model. Hvis testholdet sender sine hemmelige spørgsmål til modelproducentens almindelige system, kan spørgsmålene i princippet blive set eller senere ende i arbejdet med nye modeller. Hvis producenten i stedet udleverer selve modellen, risikerer den at afsløre kostbar teknologi. Den dobbeltblinde metode forsøger at undgå begge dele. Før testen kontrollerer parterne kryptografisk, at det aftalte programmiljø er det, der faktisk kører. Derefter overføres model og testmateriale ad krypterede forbindelser til et midlertidigt, hardwarebeskyttet rum. Her udføres prøven, og kun de på forhånd aftalte resultater kommer ud. Når miljøet lukkes, skal de midlertidige nøgler og data forsvinde med det.Gemini blev testet på hidtil urørte spørgsmål
I piloten kørte forskerne Gemini 2.5 Flash Lite på en NVIDIA H100-grafikprocessor i Google Clouds Confidential Space. OpenMined-værktøjet PySyft styrede udvekslingen mellem parterne, mens både computerens almindelige hukommelse og grafikprocessorens hukommelse var beskyttet med hardwarebaseret kryptering. En del af materialet kom fra reserven i MLCommons' AILuminate-test. Ifølge den tekniske rapport var disse spørgsmål ikke tidligere blevet behandlet af nogen model. De dækkede blandt andet cyberangreb, selvskade, hadtale, voldelig kriminalitet og farlige kemiske eller biologiske emner. Et andet privat testsæt undersøgte, om modellen kunne lokkes til at levere skadeligt indhold i en lokal sproglig og kulturel sammenhæng. Det vigtige resultat er ikke en ny placering til Gemini på en rangliste. Google og medforfatterne har ikke offentliggjort en modelscore i forbindelse med piloten. Forsøget demonstrerer i stedet, at en ekstern prøve kan gennemføres, uden at testspørgsmål og modelkode først skal udleveres åbent til den anden part.Et stærkere låsesystem er ikke det samme som en perfekt test
Metoden beskytter især mod, at hemmelige spørgsmål slipper ud og senere påvirker modeludviklingen. Den kan også gøre det lettere at genbruge en værdifuld test over længere tid, fordi færre mennesker og systemer behøver at se de konkrete opgaver. Men den afgør ikke i sig selv, om spørgsmålene er gode, dækkende eller retfærdige. En dårligt konstrueret benchmark bliver ikke bedre af at ligge i et sikkert miljø. Rapporten beskriver også praktiske huller. Ikke alle dele af Googles proprietære modelkode kunne gennemgås eller begrænses til en fuldt kontrolleret liste af tilladte funktioner. Evalueringspartneren AVERI accepterede den samlede opsætning, men det betyder, at løsningen endnu ikke fjerner al tillid mellem parterne. Forskerne peger desuden på aftaler, kodegennemgang og koordinering mellem mennesker som den største aktuelle flaskehals.Kan flytte tillid fra løfter til teknik
For brugere og virksomheder er benchmarktal ofte en hurtig måde at sammenligne modeller på. Tallene får dog mindre værdi, hvis ingen kan afgøre, om en model kendte prøven i forvejen. Den nye metode er derfor interessant, fordi den flytter en del af tilliden væk fra kontrakter og løfter om ikke at gemme data og over i et system, som begge sider kan kontrollere teknisk. Næste skridt bliver at se, om processen kan standardiseres og bruges af flere modelproducenter og testorganisationer uden omfattende specialarbejde hver gang. Først dér kan dobbeltblinde prøver blive en almindelig del af den måde, lukkede AI-modeller bliver vurderet på. Indtil videre er det en lovende pilot og en demonstration af infrastrukturen – ikke en færdig facitliste for troværdig AI-testning.Der er benyttet AI til at skrive denne artikel.